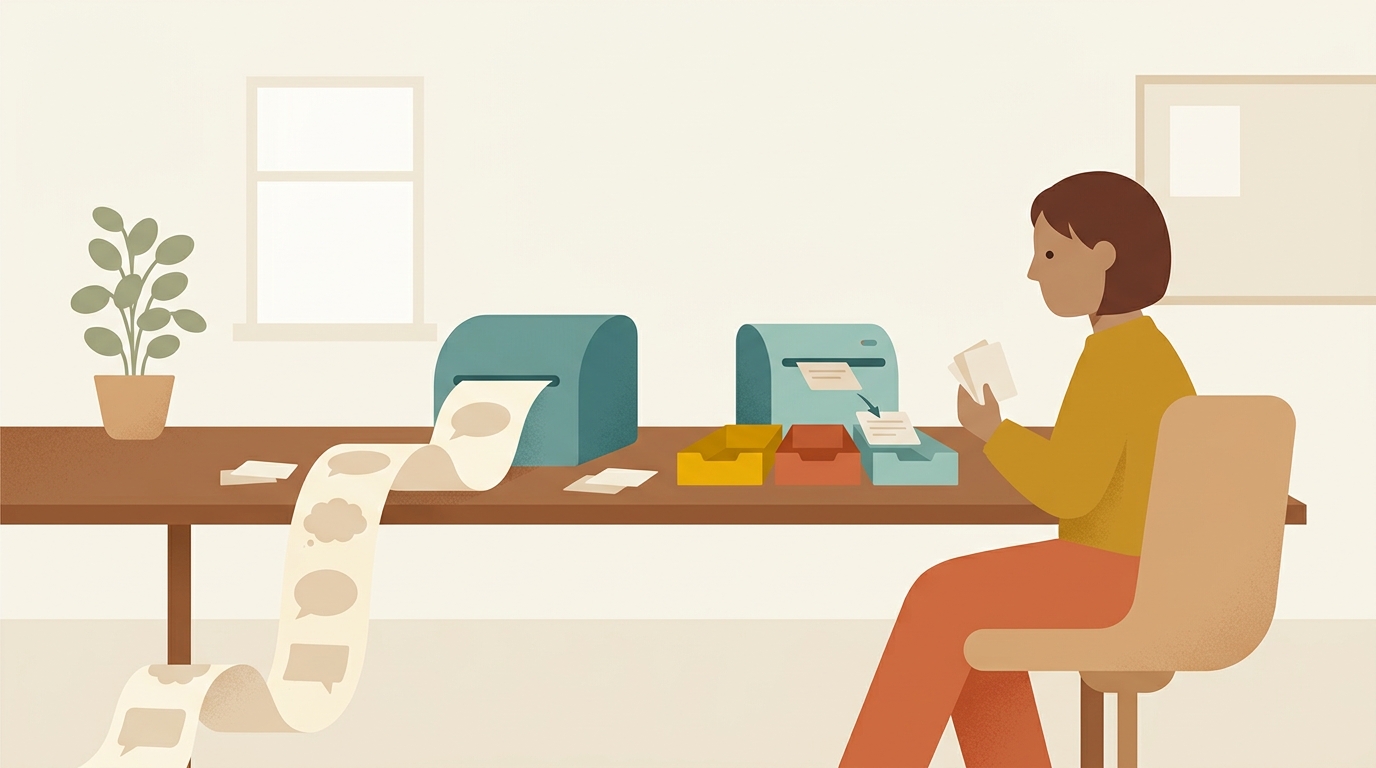
Bir karar modeli, yazılımın sizin tanımladığınız yanıtlar arasından seçim yapmasına yardımcı olur. Ona bir mesaj, bir soru ve izin verilen seçenekleri verdiğinizde, olasılıklarla birlikte bir yargı döndürür. Metin üreten bir büyük dil modeli (LLM) yeni bir yanıt oluşturabilir. Bir karar modeli ise o mesajın önce nereye gitmesi gerektiğine karar vermeye yardımcı olabilir.
TypeSafe’in Jev’i, Cloudflare’in Clef’i ve OpenAI’ın Decisions API’si bu tür sınırlı yargıları destekler. Bir uygulama bunları bir destek kuyruğu seçmek, bir sorunu belirlemek veya önem derecesini değerlendirmek için kullanabilir. Üretken bir model ise ardından gelen metin oluşturma işini üstlenebilir.
Bir mesaj, iki farklı iş
Bir müşterinin şöyle yazdığını düşünelim: “Aynı sipariş için iki kez ücretlendirildim.” Bir destek sisteminin iki işi vardır. Bileti doğru ekibe yönlendirmesi ve birinin faydalı bir yanıt yazması gerekir. Bu işler farklı çıktılar gerektirir.
Üretken bir LLM şöyle yazabilir: “Bu ücretlendirmeyi kontrol etmenize yardımcı olabilirim.” Bir karar modeli ise “Bu talebi hangi ekip ele almalı?” sorusuna billing yanıtını verebilir; bu yanıt billing, technical ve review arasından seçilmiştir.
Uygulama bu yanıtı doğrudan inceleyebilir. Bileti faturalandırma ekibine yönlendirebilir veya sonuç belirsiz olduğunda incelemeye gönderebilir. Yanıtı ardından bir kişi veya başka bir model yazabilir. Karar modeli, daha büyük bir sürecin içinde odaklanmış tek bir yargıyı ele alır. TypeSafe’in System One tanıtımı bu ayrımı açıklar.
Diyagram, aynı yönlendirme sorusunda her iki modeli karşılaştırır. Metin modeli bir JSON yanıtı üretir; karar modeli ise izin verilen üç seçeneği puanlar.
Bir karar modeline ne sorabilirsiniz?
Karar arayüzleri genel olarak üç tür soruyu destekler: bir seçenek belirlemek, bir şeyin doğru olup olmadığını tahmin etmek veya bir skor vermek. Kanıtı siz sağlarsınız ve yanıtların ne anlama geldiğini siz tanımlarsınız. Aynı müşteri mesajı birkaç ayrı değerlendirmeyi destekleyebilir.
| Soru türü | Örnek | Dönen sonuç |
|---|---|---|
| Bir seçenek belirle | İlk hangi ekip yanıt vermeli? | Seçilen ekip ve seçenekler genelinde olasılıklar |
| Evet veya hayır | Bu mesaj bir iade talebi içeriyor mu? | Yanıtın evet olma olasılığı |
| Bir skor ver | Bu sorun, tanımlı bir ölçeğe göre ne kadar ciddi? | Sağladığınız seviyelere dayalı bir derecelendirme |
TypeSafe bunları Choice, Noul ve Score olarak adlandırır. OpenAI ise choice, predicate ve score terimlerini kullanır. Predicate, evet/hayır sorusudur.
Sorunun nasıl formüle edildiği önemlidir. “İlk hangi ekip yanıt vermeli?” tek bir ekip ister. “Bu mesaj bir faturalandırma sorunu içeriyor mu?” ve “Bu mesaj bir teknik sorun içeriyor mu?” ayrı sorulardır ve her ikisine de evet yanıtı verilebilir. Bir bilet iki sorunu birden tanımlıyorsa, bunları tek bir kategoriye zorlamak faydalı bilgiyi kaybettirebilir.
LLM’den JSON istemekten farkı ne?
Bir LLM de yazılımın okuyabildiği bir veri formatı olan JSON içinde bir kategori döndürebilir. Structured Outputs ile desteklenen şemalar, yanıtı izin verilen değerlerle sınırlayabilir. Bu, bir LLM’yi birçok sınıflandırma görevi için geçerli bir alternatif haline getirir.
Fark, özel bir karar modelinin yanıtı nasıl ürettiğinde yatar. Geleneksel bir LLM, token adı verilen küçük parçalar kullanarak sırayla metin üretir. Çıktı yalnızca {"team":"billing"} olsa bile bu hâlâ metin üretimidir.
Cloudflare’in Clef’i bunun yerine girdiyi okur ve izin verilen yanıtları doğrudan skorlar; yanıtı token bazında yazmaz. Cloudflare bu yaklaşımı Clef duyurusunda açıklar. Clef, girdiyi anlamak için temel olarak hâlâ bir LLM kullanır.
OpenAI, Decisions API’sinin girdi ve çıktılarını belgeler ancak Clef’in iç tasarımını kullandığını ortaya koymaz. Benzer bir arayüz, aynı mimarinin kanıtı değildir.
Her iki yaklaşım da geçerli bir kategori döndürebilir ve yine de yanlış olanı seçebilir. Geçerli bir kategorinin hâlâ müşterinin sorunuyla eşleşmesi gerekir.
Jev, Clef ve OpenAI nerede konumlanır?
Bu ürünler, yazılımın inceleyebileceği odaklanmış yargılar sağlar. Jev, TypeSafe’in karar modelidir. Clef, Cloudflare’in indirilebilir model ailesidir ve Workers AI üzerinden de kullanılabilir. OpenAI, sınırlı sorular için bir Decisions API sunar. Aralarında seçim yapmak, gerçek görev üzerinde test etmeyi gerektirir.
| Ürün | Önce bilinmesi gerekenler |
|---|---|
| TypeSafe Jev | Metin ve yapılandırılmış veri üzerinde tip tanımlı sorular etrafında inşa edilmiştir. Eğitimi faydalı, kalibre edilmiş olasılıkları hedefler. |
| Cloudflare Clef ve Clef-flash | İndirilebilir ağırlıklar ve barındırılan hizmet olarak mevcuttur. Yayınlanan tasarımları, bir dil modeli omurgası kullanarak yanıtları skorlar. |
| OpenAI Decisions API | Seçimler, evet/hayır değerlendirmeleri ve skorlar için barındırılan bir arayüz. Şu anda gpt-6-luna kullanarak herkese açık beta sürecindedir. |
Kaynaklar: TypeSafe, Cloudflare ve OpenAI.
Yanıt formatları ve desteklenen girdileri farklılık gösterir. OpenAI ayrıca bir reddetme (refusal) yanıtı da döndürebilir; uygulamanın bunu ele alması gerekir. Bir sağlayıcıdan diğerine geçmek, hem entegrasyonu hem de yanıtların kalitesini kontrol etmeyi gerektirir.
Olasılıklar size ne söyler?
Bir olasılık, sorduğunuz soru kapsamında modelin bir yanıta ilişkin tahminini ifade eder. Uygulamanıza yalnızca kazanan etiketten daha fazla bilgi sunar. Bu sayıları, hangi durumların insan incelemesini atlayabileceğine karar vermeden önce test etmeniz gerekir.
Biletimiz için şu sonuçları ele alalım:
| İzin verilen yanıt | Örnek olasılık |
|---|---|
| Faturalandırma | %92 |
| Teknik | %5 |
| İnceleme | %3 |
Faturalandırma açık ara önde. Bir ücret ve bozuk bir gösterge paneliyle ilgili karışık bir mesaj için faturalandırma %52, teknik %43 alabilir. Faturalandırma hâlâ kazanır, ancak yakın sonuç uygulamanın inceleme talep etmesi için bir gerekçe oluşturur.
Kalibrasyon, olasılıkların birçok örnek genelinde sonuçlarla eşleşip eşleşmediğini kontrol etmek anlamına gelir. %90 civarındaki karşılaştırılabilir tahminler arasında, iyi kalibre edilmiş bir model yaklaşık %90 oranında doğru olmalıdır. %90 olarak işaretlenen tek bir yanıt yine de yanlış olabilir.
“Confidence” (güven) adlı bir alan, olasılıkların ne kadar yoğunlaştığını özetleyebilir. Bu otomatik olarak ölçülmüş bir başarı oranı anlamına gelmez. TypeSafe’nin güven rehberi bu ayrımı açıklar.
Karar modelleri ne zaman faydalıdır?
Karar modelleri, görev anlamı yorumlamayı gerektirdiğinde ve olası yanıtlar zaten bilindiğinde faydalıdır. Örnekler arasında mesajları yönlendirme, ilgili belgeleri seçme ve bir öğeyi bir rubriğe göre değerlendirme yer alır. Metin yazma veya araştırma işini üstlenen üretken bir modelin yanında çalışabilirler.
Üretilmiş bir yanıttan kaçınmak modelin iş yükünü azaltabilir. Bunun hızı veya maliyeti iyileştirip iyileştirmediği; ağ gecikmeleri, girdi boyutu ve yedek çağrılar dahil olmak üzere tüm uygulamaya bağlıdır. Bir karar modelini, aynı kısa yanıtı istenen bir LLM ile karşılaştırın; gereksiz yere uzun bir açıklama talep eden bir LLM ile değil.
Sınırları da vardır. Bir karar modeli mesajı yanlış okuyabilir, izin verilen yanlış bir seçeneği seçebilir veya aşırı derecede emin olabilir. Bağımsız Red Hat guardrail testleri, Jev’in bir görevde en güçlü olduğunu, alternatiflerin ise başka bir görevde onu geçtiğini bulmuştur. Bu testler üç ürünün tamamını karşılaştırmamıştır.
Kesin hesaplamalar ve izin kontrolleri için standart kod kullanın. Görev yeni bir yanıt, kod veya açıklama gerektirdiğinde üretken bir model kullanın. Bir karar modelini denemek için tek bir küçük değerlendirmeyi ele alarak başlayın, bilinen yanıtlara sahip örnekler toplayın ve hatalarını sağladığı iş tasarrufuyla birlikte ölçün.
Sıkça sorulan sorular
Bir karar modeli açıklama yazabilir mi?
Jev ve Clef’in karar arayüzleri yeni metin yerine seçimler ve puanlar döndürür. OpenAI’ın Decisions API’si de sınırlı yanıtlar verir. Uygulamanın yazılı bir açıklamaya ihtiyacı varsa metin üreten bir model kullanın.
Bir karar modelini denemek için eğitim verisine ihtiyacım var mı?
Yeni bir model eğitmeden soruları ve izin verilen yanıtları tanımlayabilirsiniz. Yine de doğruluğu kontrol etmek ve hangi sonuçların otomatik olarak kullanılabileceğine karar vermek için bilinen sonuçlara sahip örneklere ihtiyacınız vardır.
Bir karar modeli kendi başına eylem gerçekleştirebilir mi?
Bir karar modeli bir değerlendirme döndürür. Uygulamanız bunu kullanıp kullanmayacağına karar verir, izinleri kontrol eder ve eylemi yürütür. Bir iade etiketi seçmek, iadeyi onaylamaz.